Formation Deep Reinforcement Learning (5 jours)
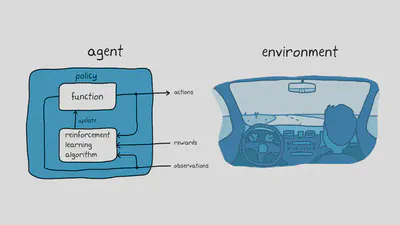
Une formation de cinq jours au Deep Reinforcement Learning, qui alterne théorie et pratique avec Stable-Baselines3 et OpenAI Gym : le cours le matin, la mise en pratique l’après-midi, et un projet final sur un environnement tiré de votre métier.
Le programme ci-dessous est un programme type, adaptable à vos besoins et au temps disponible.
Jour 1 : Les bases du Reinforcement Learning
Matin
- Ce qu’est le RL, et ce qui le distingue de l’apprentissage supervisé et non supervisé
- Les briques de base : agent, environnement, états, actions, récompenses
- Des applications concrètes : jeux, robotique, finance
- Le vocabulaire : politique, valeur d’état, valeur d’action, récompense, retour ; processus de décision markovien (MDP)
Après-midi
- Les méthodes tabulaires : Monte Carlo, différences temporelles (TD), SARSA, Q-learning
- Leurs forces, leurs limites et leurs cas d’usage
- Pratique : implémenter un Q-learning simple sur FrozenLake (OpenAI Gym)
Jour 2 : Les environnements OpenAI Gym
Matin
- Le rôle de l’environnement dans l’entraînement d’un agent
- Les environnements standards : CartPole, MountainCar…
- Manipuler un environnement :
env.reset(),env.step(),env.render() - Les espaces d’actions et d’observations
Après-midi
- Créer son propre environnement avec l’API de Gym
- Pratique : un jeu simple avec une logique de récompense sur mesure
Jour 3 : Stable-Baselines3
Matin
- Pourquoi SB3 : des implémentations fiables de DQN, PPO, A2C…
- Installation et configuration
- Brancher un environnement Gym sur SB3, premier entraînement de PPO sur CartPole
Après-midi
- Pratique : optimiser un agent PPO sur CartPole
- Les callbacks pour piloter l’entraînement : arrêt anticipé, suivi des métriques
Jour 4 : Les algorithmes avancés
Matin : Deep Q-Network (DQN)
- Des méthodes tabulaires aux réseaux de neurones
- Replay buffer, target network
- Pratique : DQN avec SB3 sur LunarLander
Après-midi : Actor-Critic (A2C, PPO)
- Le principe de l’Actor-Critic
- Ce que PPO apporte par rapport à DQN : efficacité d’échantillonnage, stabilité
- Pratique : PPO sur un environnement continu, BipedalWalker
Jour 5 : Déploiement et projet sur votre métier
Matin
- Sauvegarder et recharger un agent entraîné
- L’évaluer sur des épisodes jamais vus à l’entraînement
- L’intégrer dans une application réelle : robots, simulations, jeux
Après-midi : projet final
- Un projet complet sur un environnement tiré de votre métier : modélisation, choix de l’algorithme, entraînement, réglage et évaluation
- Bilan : les difficultés rencontrées et les pistes pour aller plus loin